
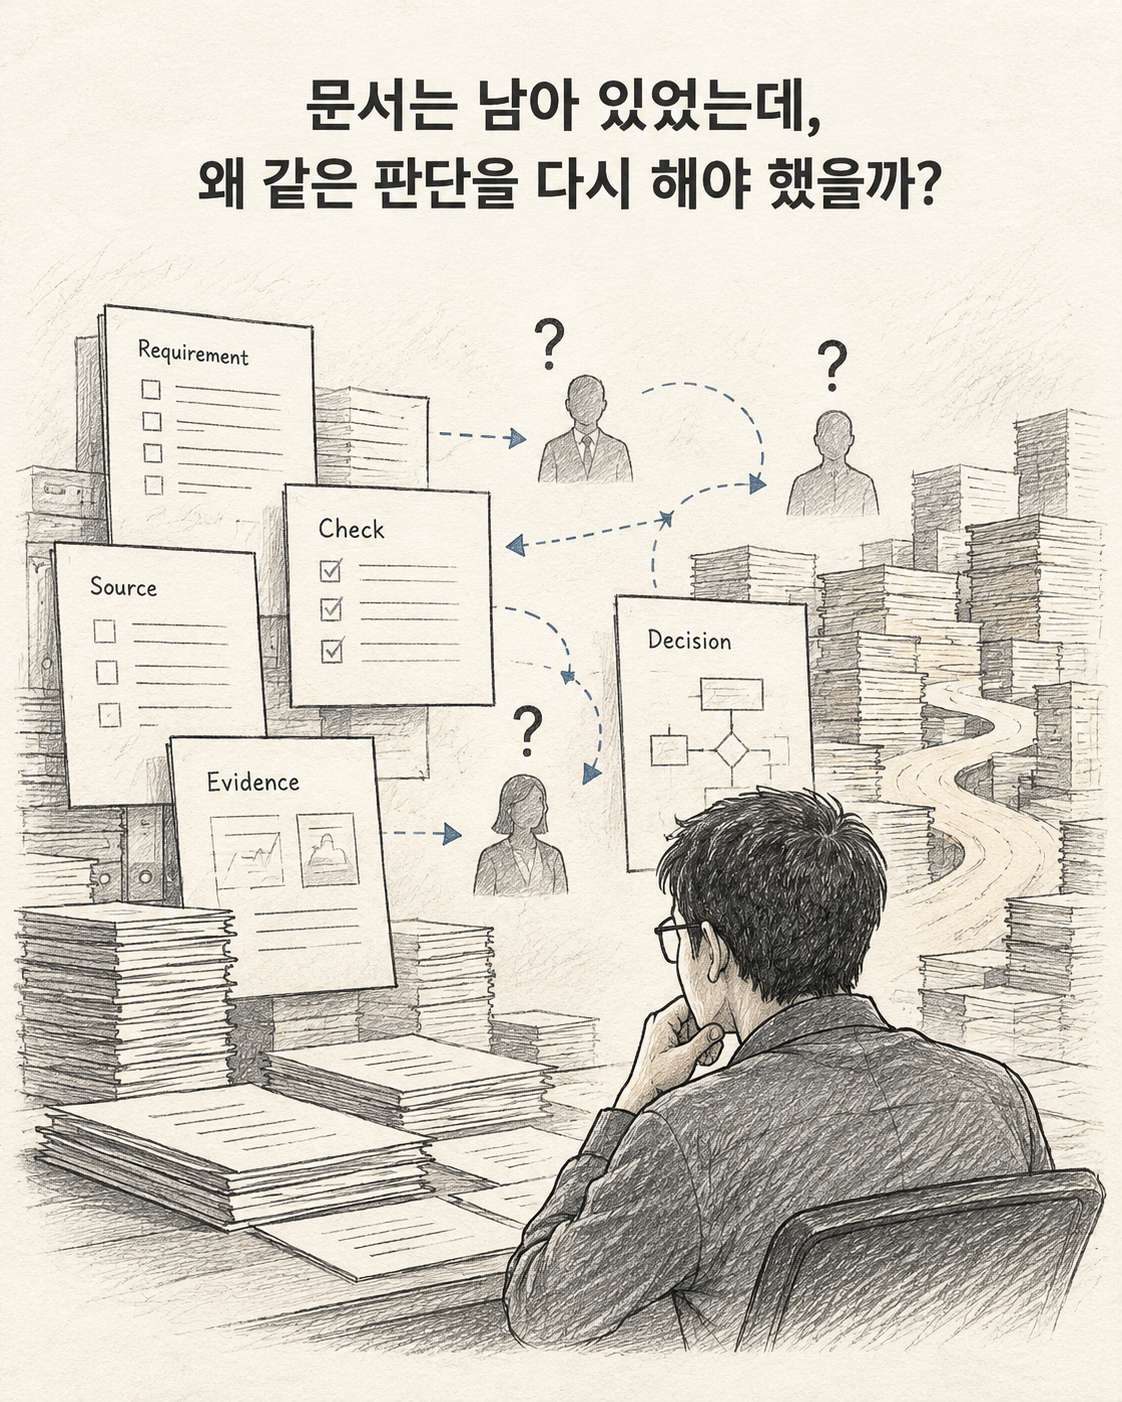
문서를 남기는 것과 판단을 다시 사용할 수 있게 남기는 것은 달랐다
Project에는 이미 많은 문서와 기록이 남아 있었다.
Spec, RTL, Test Plan, Regression Result, Wiki, Issue, Review Note, Decision도 남았다.
그런데 시간이 지나 같은 문제를 다시 보면 이상한 일이 생겼다.
자료는 있는데 왜 이렇게 판단했고 이런 Decision을 내렸는지를 다시 조사해야 했다.
어떤 Source version을 봤는지,
어떤 Condition에서 어떤 Test를 확인했는지,
어떤 Evidence 때문에 Exception을 받아들였는지 다시 찾아야 했다.
문서를 남기는 것과 판단을 다시 사용할 수 있게 남기는 것은 다른 일이었다.
분류보다 관계가 필요했다
처음에는 자료를 잘 분류하면 도움이 될 것이라고 생각했다.
Requirement, Source, Test, Evidence, Issue, Decision을 구분해서 정리하면 찾기는 쉬워진다.
하지만 다음 Engineer에게 필요한 것은 분류만이 아니었다.
이 Requirement 때문에 이 Source를 봤고,
이 조건에서 이 Test와 Checker를 확인했고,
이런 Evidence가 있었기 때문에 이런 Decision을 내렸다는 연결이 필요했다.
Requirement에서 Source와 Condition으로,
Check와 Test로,
Evidence와 Result로,
그리고 Decision으로 이어지는 관계였다.
그리고 Change나 Issue가 생기면 무엇을 다시 봐야 하는지 그 관계를 따라갈 수 있어야 했다.
모든 Relation이 AI가 추론한 것은 아니었다
관계를 남기는 방식도 하나가 아니었다.
Requirement ID가 특정 Test metadata에 명시되어 있거나,
어떤 Run이 어떤 Source revision과 Configuration을 사용했는지,
어떤 Checker가 어떤 Result를 만들었는지는 System이 직접 기록할 수 있었다.
반대로 Requirement 문장과 기존 Test의 Behavior를 비교해 Coverage Gap 후보를 찾거나,
서로 다른 Issue와 Failure 사이의 유사성을 찾거나,
Change가 어떤 영역에 영향을 줄 가능성이 있는지를 제안하는 일에는 AI가 도움이 될 수 있었다.
하지만 AI가 찾아낸 Relation은 Candidate였다.
명시적으로 기록된 Relation과 같은 수준의 현재 Truth로 바로 승격시키면 안 됐다.
Ontology라는 이름은 나중에 알게 됐다
이런 관계를 정리하던 중 나중에 Ontology라는 개념을 접했다.
그때 알게 된 것은 새로운 이름보다 익숙한 Engineering 문제였다.
SoC 개발에서도 RTL hierarchy, Verification traceability, Register Model, Constraint, IP Metadata처럼 대상과 관계를 다루는 구조는 이미 존재한다.
내가 Ontology를 적용하려고 관계를 만든 것은 아니었다.
같은 판단을 반복하지 않으려고 관계를 남기다 보니 내가 필요하다고 느낀 구조가 그 사고방식과 닮아 있다는 것을 뒤늦게 알게 됐다.
Tool 사이의 의미는 사람의 경험에 남아 있는 경우가 많았다
내가 경험한 환경에서는 각 Tool이 자기 Domain의 구조와 Result를 제공해도, Tool 사이의 의미를 연결하는 일은 Senior Engineer의 경험에 많이 의존했다.
특정 Error 뒤에 어떤 Constraint를 먼저 봐야 하는지,
어떤 Test가 PASS했어도 어떤 Corner를 추가로 확인해야 하는지,
과거 Waiver가 현재 Version에도 적용되는지는 Wiki, Script, Issue History와 사람의 기억에 흩어져 있을 수 있었다.
Agent가 Requirement 변경 영향이나 Test Gap을 찾으려면 Spec, RTL, Verification, Issue History, Tool Result를 가로질러야 한다.
그래서 Requirement, Source, Check와 Test, Evidence, Decision, Change가 어떤 의미로 연결되는지를 System에서도 따라갈 수 있게 만들 필요가 있었다.
관계가 있다고 바로 현재 판단 근거가 되는 것은 아니었다
Requirement 하나가 Test 하나와 연결돼 있다는 사실만으로는 현재 Project의 판단 근거가 되지 않는다.
어떤 Source와 Version인지,
어떤 Configuration과 Corner인지,
실제 Checker와 Evidence가 무엇인지,
그 이후 Change가 있었는지를 함께 봐야 했다.
그리고 그 Relation이 명시적으로 기록된 것인지,
Tool Result에서 직접 확인된 것인지,
AI가 의미를 해석해 만든 Candidate인지도 구분할 수 있어야 했다.
Relation exists와 Applicable, Verified 또는 Qualified는 같은 의미가 아니었다.
그래서 범용 Knowledge Graph를 크게 만드는 것보다 다음 Engineering 판단에서 실제로 필요한 관계와 조건을 남기는 쪽으로 생각을 좁혔다.
나는 이것을 Engineering Context Relationship이라는 관점으로 정리하기 시작했다.
중요한 것은 이름이 아니라 다음 사람이 어떤 조건에서 어떤 근거를 보고 어떤 판단과 Decision에 도달했는지를 다시 따라갈 수 있는가였다.
Change가 생겼을 때 관계의 가치가 더 커졌다
Requirement나 Source가 바뀌면 명시된 Relation을 따라 관련 Test와 Checker, 이전 Evidence와 Decision을 찾을 수 있다.
AI는 그 위에서 추가 영향 후보나 누락 Relation을 제안할 수 있다.
이것이 자동 Impact Analysis가 완성됐다는 뜻은 아니다.
Relationship과 AI가 찾은 Candidate는 영향 범위와 Re-check 대상을 찾기 위한 출발점일 뿐이었다.
현재 Project에 실제로 적용할 수 있는지, 어떤 Review가 필요한지는 다시 확인해야 했다.
그런데 Relation이나 Gap을 찾았다는 사실만으로 그것을 다음 Decision의 근거로 바로 사용할 수도 없었다.
다음 질문은 무엇을 실제 Decision Basis로 재사용해도 되는가였다.