
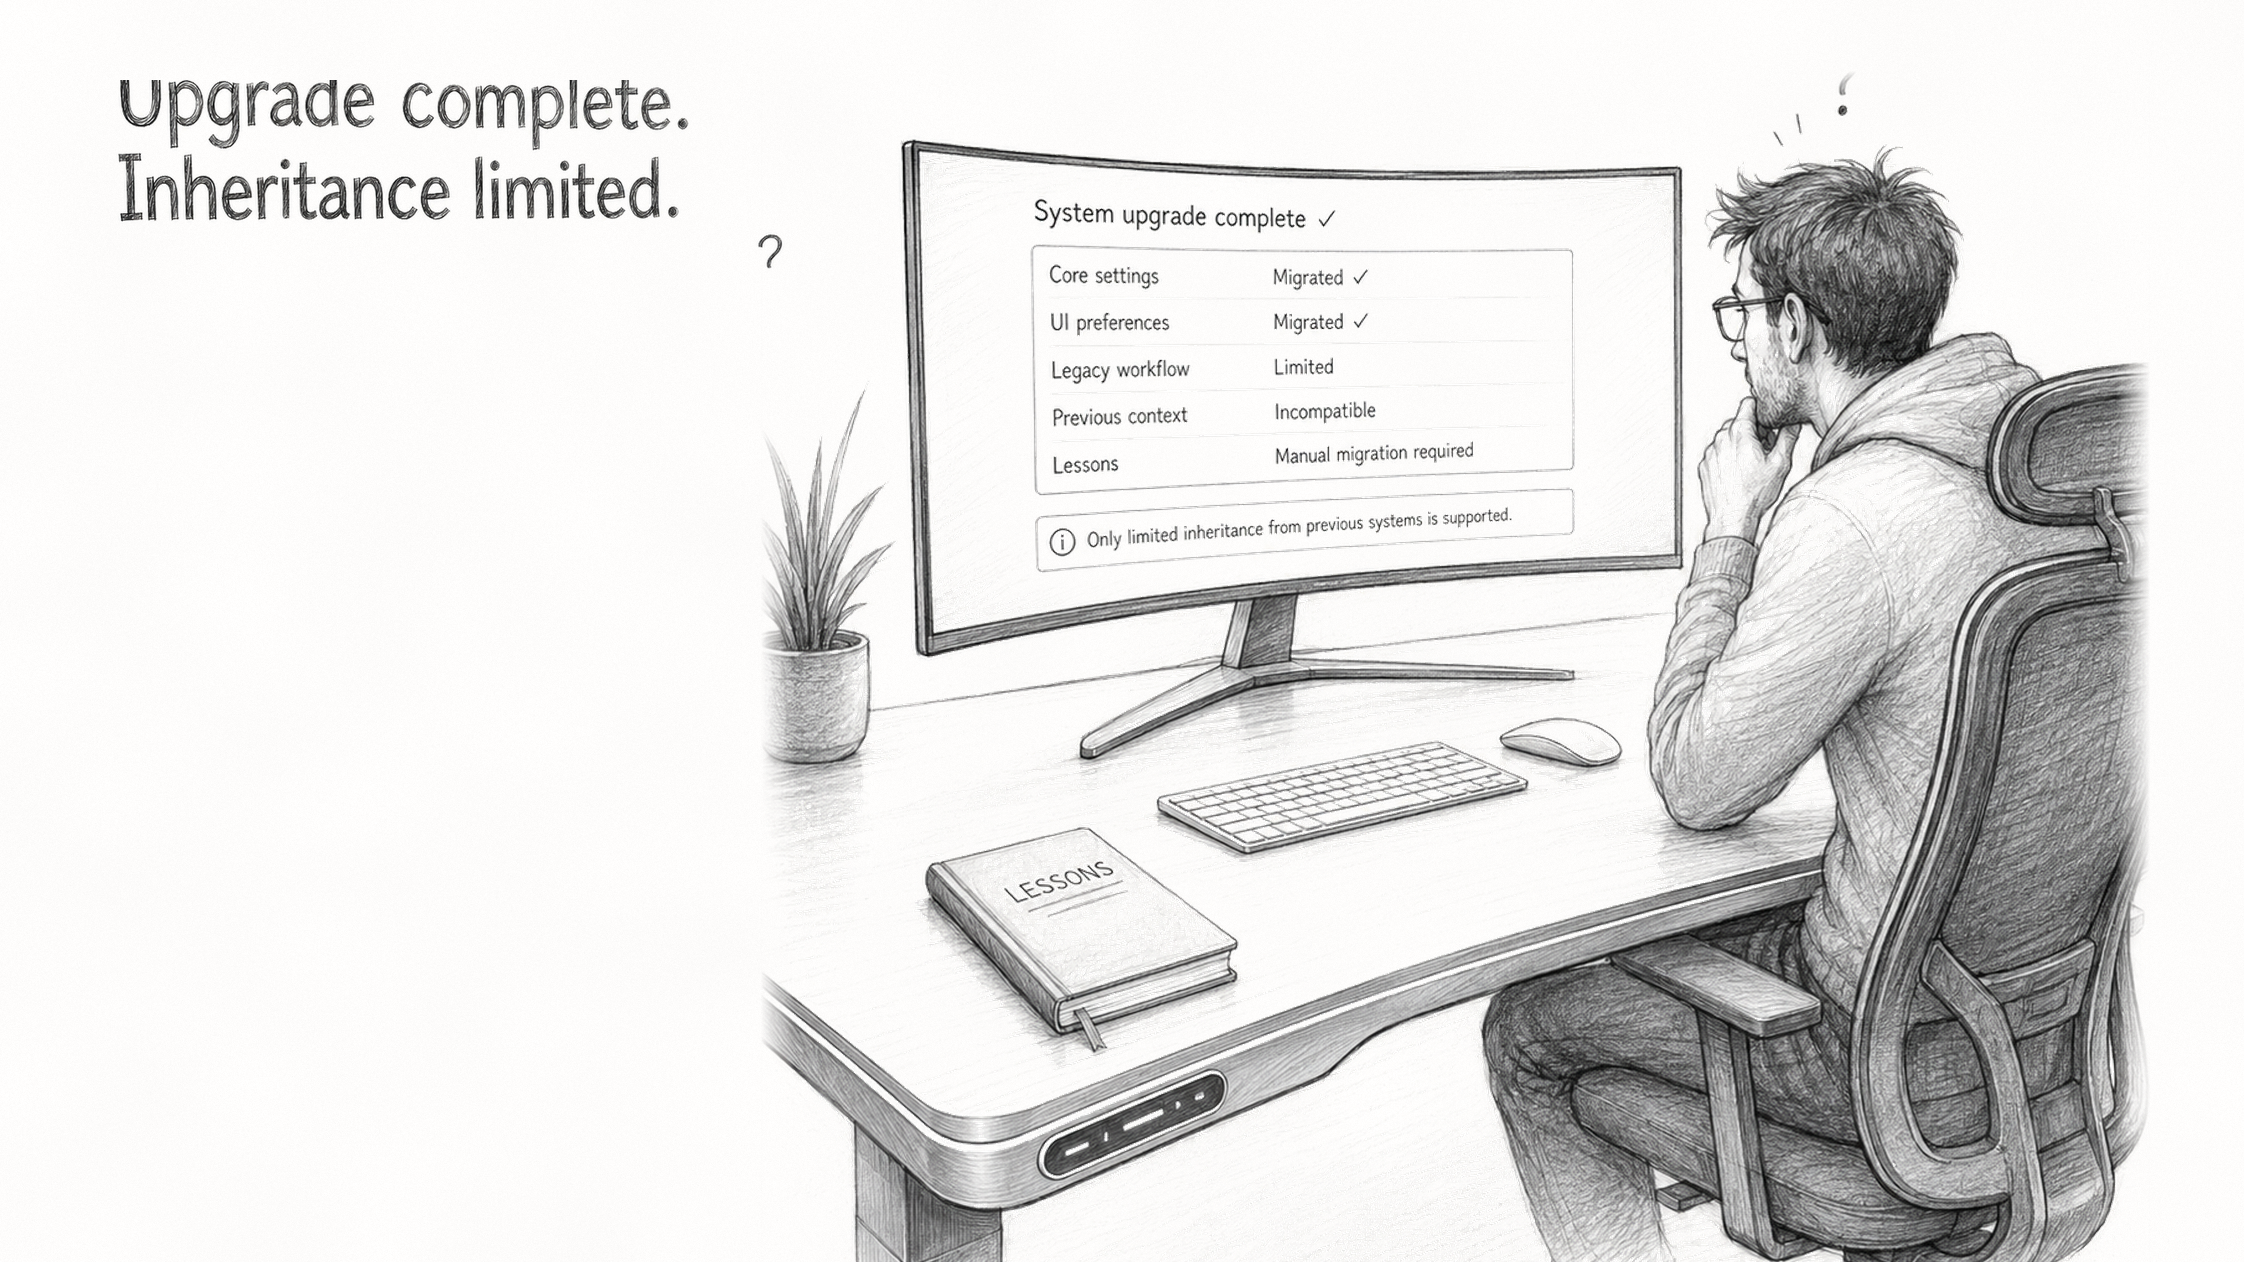
5편에서 비슷한 문제가 계속 반복되는 Recurring Fix Loop를 겪으면서, Script나 Agent 하나보다 Component 사이의 관계와 State를 관리하는 Harness가 필요하다는 생각으로 이동했다.
그런데 Harness를 만들기 시작하자 곧 또 다른 질문이 생겼다.
“Model이나 Agent 환경이 바뀌면 이것도 다시 만들어야 하는 것 아닐까?”
AI 환경은 빠르게 변한다.
Model이 바뀔 수 있다.
Agent Runtime이 바뀔 수 있다.
Framework와 Inference Interface도 바뀔 수 있다.
반면 SoC 업무에서 시행착오로 얻은 Knowledge와 Engineering Rule은 가능한 한 오래 남아야 한다.
바뀌는 속도와 관리 주기가 다른 두 종류의 자산을 한 덩어리로 묶어 놓으면 AI 환경 하나를 바꾸는 일이 Knowledge와 Harness 전체를 다시 손대는 문제로 커질 수 있었다.
내가 정말 다시 만들고 싶지 않았던 것은 Code 자체보다 Learning이었다.
어떤 Input에서 문제가 생겼는지, 어느 State에서는 진행하면 안 되는지, 어떤 Condition을 먼저 확인해야 하는지, 어떤 접근이 실패했는지, Component 사이에 어떤 Contract가 필요한지, 어디에서 Human Decision이 필요한지.
이런 내용은 몇 번의 시행착오를 거쳐야 알게 되는 Engineering Asset이었다.
“환경을 바꾼다는 이유로 이 시행착오까지 다시 겪고 싶지는 않았다.”
4편에서 Model 자체에 Domain Knowledge를 계속 학습시키는 방법을 생각하면서 “Knowledge Asset과 Model Weight가 같은 성격의 자산일까?”라는 질문을 남겼다.
Harness 경험을 거친 뒤 이 질문은 조금 더 분명한 Architecture 판단으로 바뀌었다.
Model이 바뀌어도 Knowledge가 남아야 한다면, 조직의 Knowledge와 Engineering Rule을 Model과 분리된 자산으로 관리하는 편이 맞지 않을까?
Model·Agent Runtime처럼 자주 바뀌는 부분과 Knowledge·Engineering Rule처럼 오래 남겨야 하는 부분을 변경 이유와 관리 주기에 따라 분리하는 방식은 S/W, System Engineering에서 말하는 Separation of Concerns와 같은 원칙이다.
쉽게 말하면 바뀌는 이유와 관리 주기가 다른 것들을 가능한 한 분리해서 관리하는 것이다.
내가 보기 시작한 두 영역은 이랬다.
바뀔 수 있는 AI Environment: Model — coding/reasoning 중심 Model, 범용 Local LLM, 조직별 목적에 맞춘 Model 등 Agent Runtime — pi-coding-agent, CLI 기반 Agent Runtime, 사내 Runtime 등 Framework — Tool Orchestration, Multi-step Workflow, Multi-agent Framework 등 Inference Environment — Local Model Server, Container 기반 Serving, GPU Runtime 구성 등 API/Interface — REST API, OpenAI-compatible API, CLI/SDK Interface 등 Environment-specific Integration — EDA Tool 호출 Wrapper, Repository/Path 연동, GPU·Driver 환경 설정 등
조직에 남아야 할 Engineering Asset: Intent, Knowledge, Engineering Rule, Skill, Policy, Contract, Failure Learning, Harness의 핵심 Pattern.
이때부터 Agent 자체도 Solution의 중심이라기보다 필요하면 바꿀 수 있는 실행 Component로 보기 시작했다.
그리고 이 원칙은 실제 Agent Runtime 선택 기준으로 이어졌다.
가장 기능이 많은 Agent를 찾기보다, 나중에 환경이 바뀌어도 지금 쌓는 Knowledge와 Harness를 최대한 남길 수 있는 Runtime을 원했다.
내가 당시 중요하게 본 조건은 네 가지였다.
Open Source 특정 Vendor나 폐쇄적인 Platform에 핵심 구조가 깊게 묶이는 것을 줄이고, 필요하면 내부 동작을 확인하고 수정할 수 있어야 했다.
CLI-first SoC 개발은 Shell, Script, Repository, Build/Run, EDA Tool, Log/Result를 중심으로 움직인다.
별도의 복잡한 GUI보다 기존 Engineering Workflow에 자연스럽게 연결되는 구조가 중요했다.
Lightweight Local AI를 도입하더라도 AI를 운영하기 위한 Runtime과 부가 구조가 조직의 Compute와 운영 여력을 과도하게 차지해 실제 SoC 개발에 사용할 Resource를 잠식하는 구조는 피하고 싶었다.
AI를 위한 구조는 가능한 한 가볍게 두고, Resource는 실제 Engineering Work에 더 많이 사용할 수 있어야 했다.
Easy to Extend & Maintain Source가 공개되어 있어도 Architecture가 너무 복잡하면 작은 Customization 하나가 장기 Maintenance 부담으로 돌아올 수 있다.
이 기준을 검토한 결과 당시에는 pi-coding-agent가 내가 찾던 방향과 잘 맞아 선택했다.
중요한 것은 “pi-coding-agent가 최고의 Agent였다”는 주장이 아니다.
오히려 이 글의 논리대로라면 pi-coding-agent 역시 필요하면 교체할 수 있어야 한다.
자산으로 남겨야 할 것은 특정 Runtime 자체보다 왜 그것을 선택했는지에 대한 Decision Rationale(On-Premise 요구, Tool Calling 안정성, Resource 사용량, 유지보수성, Vendor 종속성 등)과 그 과정에서 얻은 Learning이었다.
여기서 Reuse의 의미도 조금 더 현실적으로 정리할 필요가 있었다.
AI 환경을 특정 Model이나 Runtime에 종속시키지 않는다고 해서 아무 수정도 필요 없다는 뜻은 아니다.
Model이나 Runtime이 바뀌면 Context 처리 방식, Tool Calling, Output, Interface, Integration이 달라질 수 있다.
그래서 변경된 환경과 직접 맞닿은 부분은 옮기거나 맞추는 수정(Migration)이 필요하고, 변경된 환경의 영향을 받은 부분이 여전히 기대한 대로 동작하는지 다시 확인하는 작업(이후 Re-qualification으로 표현)도 영향 범위에 따라 필요할 수 있다.
내가 원한 것은 Copy & Run이 아니었다.
Core Asset은 유지하고, 변경된 환경과 직접 맞닿은 부분만 필요한 만큼 수정하거나 Migration하고, 영향 수준에 맞게 다시 확인하는 구조였다.
Core Asset 유지 + 필요한 부분만 Migration + 영향 수준에 맞는 Re-qualification.
Harness 자체에도 Learning은 계속 쌓였다.
어떤 Contract가 필요한지, 어떤 State를 확인해야 하는지, 어떤 Rule을 강제해야 하는지, 어디에서 문제가 반복되는지.
그러다 또 한 가지 질문이 생겼다.
AI 환경이 바뀔 때 Harness Learning을 다시 만들고 싶지 않은 것처럼, SoC 업무마다 Harness 자체를 처음부터 다시 만드는 것도 결국 반복 비용 아닐까?
그런데 실제 SoC 개발에서는 하나의 Harness만 존재하는 것도 아니었다.
Spec 처리, RTL/Simulation, Regression, Log 분석, Handoff처럼 업무가 나뉘면서 서로 다른 Harness가 생길 수 있었다.
각각의 Harness 안에서는 잘 동작해도 Harness 사이의 Input·Output, State, Rule, 완료 조건이 다르면 5편에서 Component 사이에서 봤던 것과 비슷한 mismatch가 다시 생길 수 있었다.
Component와 Agent 사이의 mismatch를 Harness로 관리했는데, 여러 Harness 사이에서 다시 mismatch가 생긴다면 그것은 어디에서 관리해야 할까?
각 Harness를 개별적으로 다시 수정하는 것보다 여러 Harness가 어떤 Rule과 Interface로 연결되고 어떤 공통 기준을 따라야 하는지를 더 바깥에서 바라보는 Control 구조가 필요하다고 생각했다.
또 하나의 문제는 Harness마다 비슷한 Control을 서로 다른 방식으로 다시 구현하기 시작한다는 점이었다.
Input Validation, State 확인, Stop Condition, Permission, Evidence 생성, Human Escalation 같은 기능은 여러 업무에서 반복되는데, 이를 Harness마다 다른 방식으로 만들면 유지보수도 어려워지고 Harness 사이의 연결 방식도 제각각이 될 수 있었다.
그렇다고 모든 조직의 Harness를 하나의 Rule로 통일하려는 것은 아니었다.
SoC 개발 방식과 Review 기준, Permission, Tool Flow, Sign-off 기준은 조직마다 다를 수 있다.
공통으로 재사용할 수 있는 Control 구조와 조직별 Engineering Rule은 분리할 필요가 있었다.
내가 줄이고 싶었던 것은 조직마다 다른 Rule 자체가 아니라, 그 Rule을 적용하기 위한 Harness 구조까지 매번 처음부터 다시 만드는 일이었다.
공통 Control과 Interface는 재사용하고, 조직별 Rule과 Policy, Contract는 필요한 만큼 바꿔 적용할 수 있다면 구축 시간과 시행착오를 줄일 수 있다고 생각했다.
이런 경험을 거치면서 나는 여러 SoC 업무의 Harness를 더 바깥에서 바라보며, Harness 사이의 연결 조건과 공통 Control을 관리하고, 조직별 Rule은 분리해서 적용할 수 있는 상위 구조를 생각하기 시작했다.
이것을 Meta Harness라고 정리했다.
Harness가 특정 Engineering Workflow 안에서 Agent와 Component의 실행을 통제한다면, Meta Harness는 여러 Harness 사이의 Rule·Interface·State·Control 방식이 서로 어긋나지 않도록 관리하면서 공통 구조를 재사용하기 위한 바깥의 Control Layer에 가깝다.
모든 Harness를 하나로 합치자는 의미는 아니다.
각 조직과 업무에 필요한 Domain Rule은 그대로 유지하되, 반복되는 Control 방식과 연결 기준은 가능한 한 표준화하고 재사용하자는 방향이었다.
Meta Harness까지 생각하면서 AI Environment와 Engineering Asset을 분리해야 한다는 방향은 조금씩 분명해졌다.
하지만 바꿀 수 있게 만드는 것과, 실제 업무에 바꿔 넣어도 되는지를 판단하는 것은 다른 문제였다.
Model, Agent Runtime, Inference Environment를 바꿀 수 있게 만들었다고 해서 아무 AI Environment나 실제 SoC 업무에 넣을 수 있는 것은 아니었다.
그렇다면 새로운 AI Environment를 선택할 때 무엇을 확인해야 할까?
Benchmark가 높은 Model이면 충분할까?
Tool Calling이 되면 충분할까?
Local에서 실행되기만 하면 충분할까?
결국 다음으로 필요했던 것은 “우리의 실제 SoC 업무 조건에서 이 AI Environment가 사용할 수 있는 수준인지 어떻게 판단할 것인가”에 대한 기준이었다.
다음 편 — 그렇다면 실제 SoC 업무에 사용할 Local AI는 어느 정도면 충분할까?