
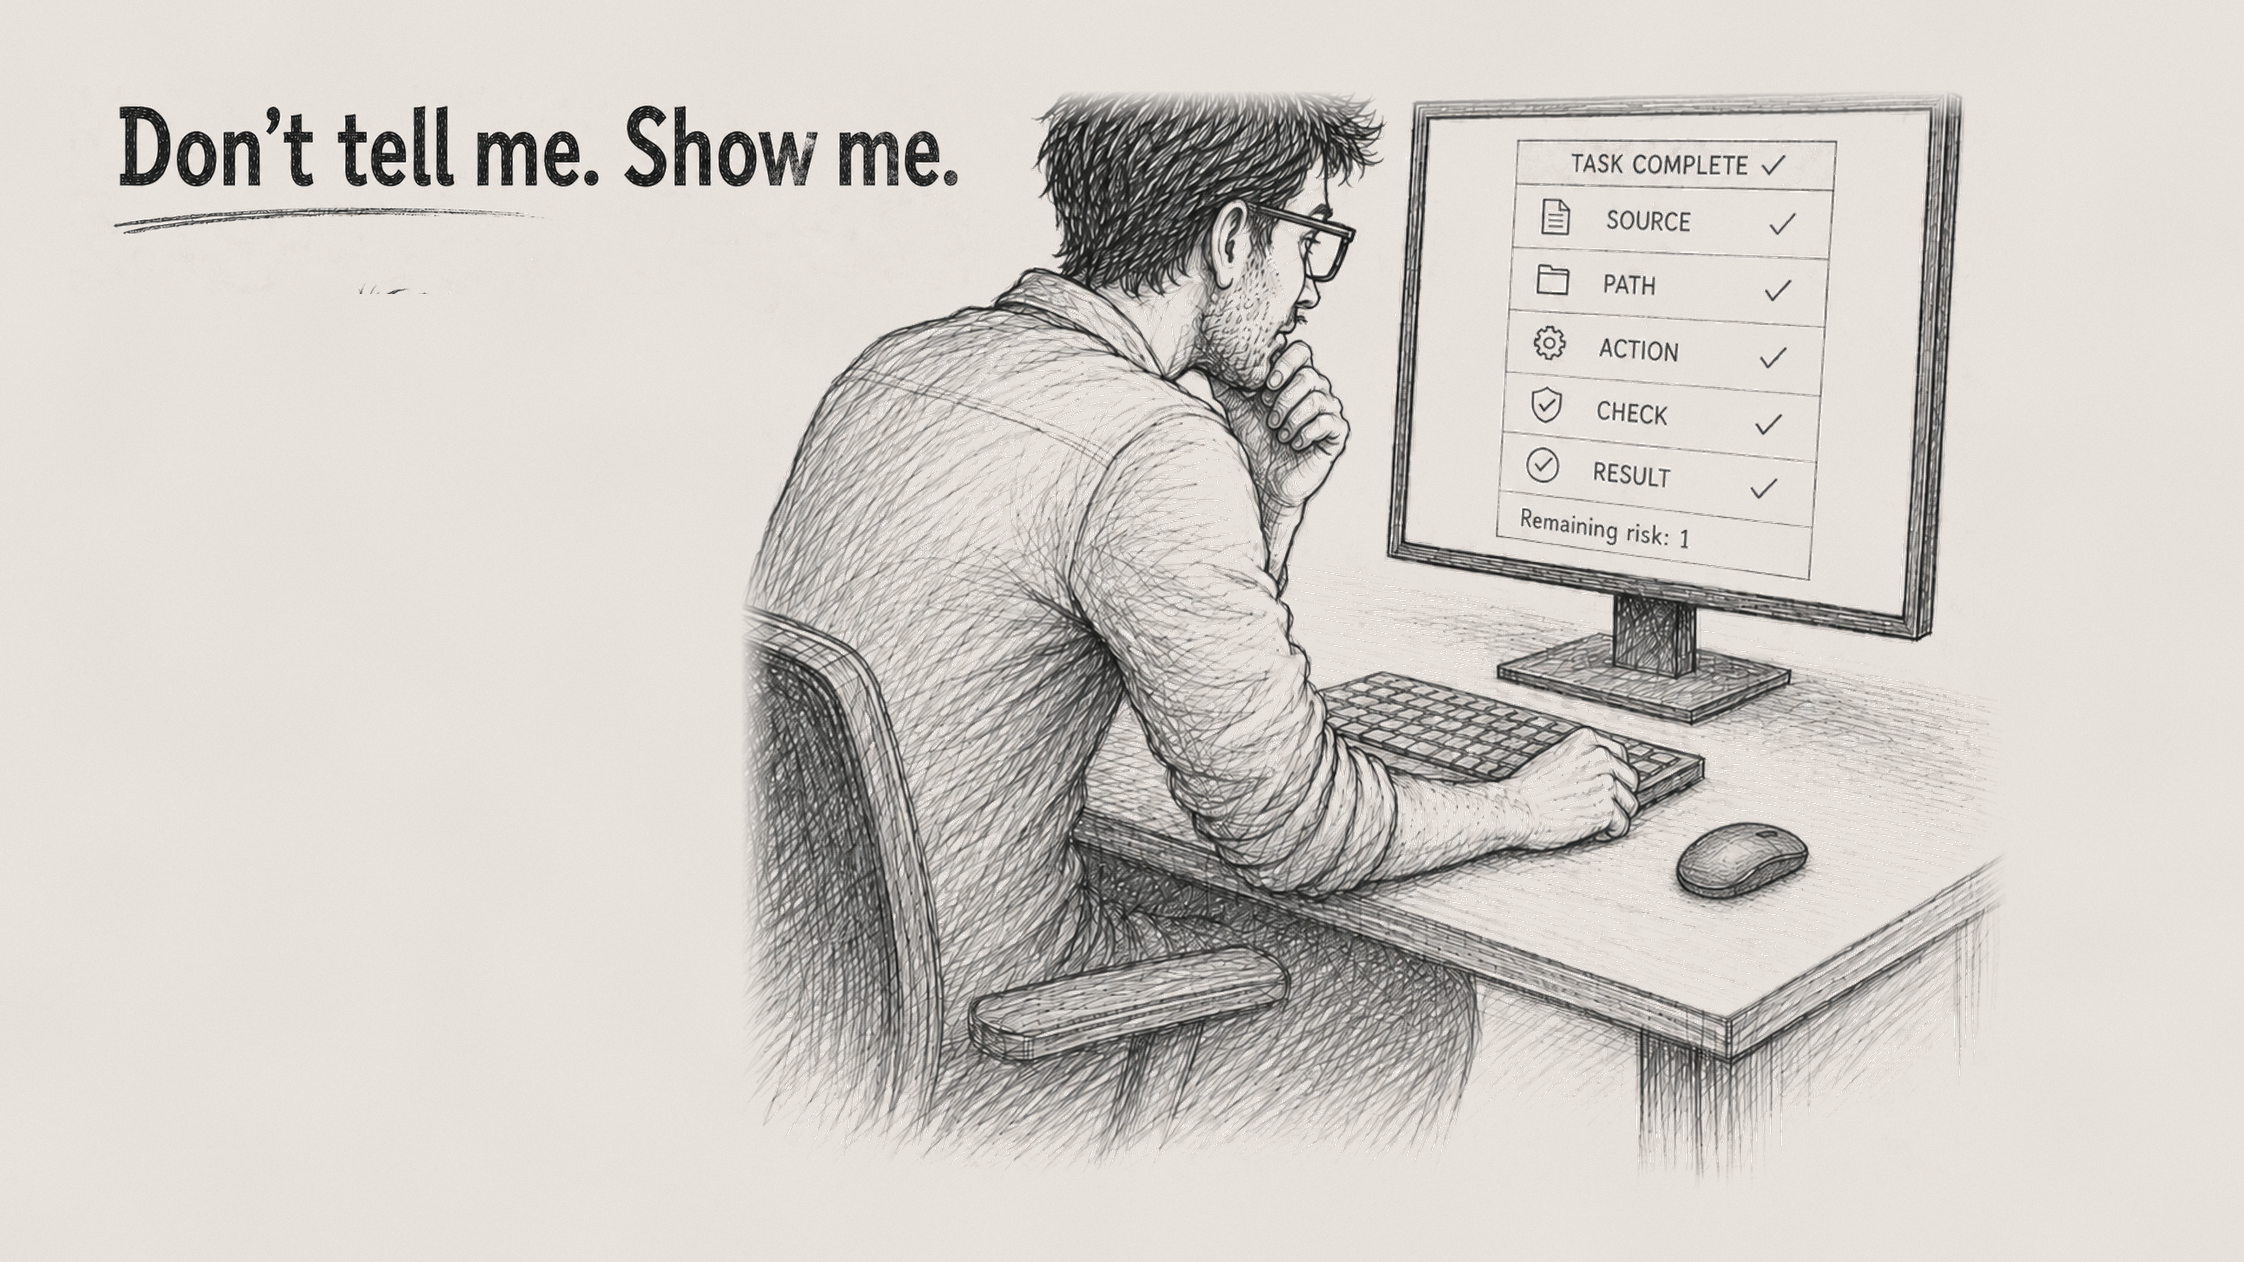
8편에서 Agentic Capability와 Engineering Reliability는 같은 것이 아니라고 이야기했다.
앞 Step의 Output 구조를 확인하고, Repository에 실제로 존재하는 Source를 먼저 보고, 반복 시 멈추는 조건과 Session 복구 절차를 넣으면 Workflow는 분명 더 안전해진다.
그런데 Harness가 복잡해질수록 새로운 문제가 생겼다.
“이 Control들이 실제로 수행됐다는 것을 사람은 어떻게 알 수 있을까?”
초기의 단순한 Request → Script 실행 → Result 정도는 Console을 직접 보면 됐다.
하지만 Input 확인, State 확인, Inventory 확인, Tool 실행, Output Validation, Retry, Stop Condition, Recovery, 다음 Step으로 이어지는 다단계 Workflow에서는 사람이 모든 실행을 처음부터 끝까지 눈으로 따라가기 어려웠다.
이런 통제가 늘어날수록 사람이 실제로 무엇이 수행됐는지 빠르게 확인할 수 있는 구조가 더 중요해졌다.
PoC에서는 Agent가 사용자가 기대한 것과 다른 작업을 수행한 뒤에도 자신이 가진 Context와 Success Condition 기준에서는 작업을 끝냈다고 판단해 “완료했습니다”라고 보고하는 경우도 있었다.
이것을 AI가 거짓말했다고 표현하는 것은 정확하지 않다.
더 정확한 문제는 Agent가 판단한 Completion과 Human이 기대한 Completion이 다를 수 있다는 것이다.
Agent의 완료 보고 ≠ Engineering Evidence
사람이 확인하고 싶은 것은 “성공했습니다”라는 결론보다 그 결론에 도달한 근거였다.
어떤 Input을 사용했는가.
그 Input의 Version과 Source는 무엇인가.
어떤 Tool과 Condition으로 실행했는가.
실제 Output은 무엇인가.
어떤 Check를 수행했는가.
무엇이 Skip되었는가.
어떤 Exception과 Remaining Risk가 있는가.
왜 Success라고 판단했는가.
여기서 1편의 문제가 다시 돌아왔다.
1편에서는 Decision Maker의 Review를 위해 Engineer가 Log와 Result를 다시 찾아 Excel, PPT, Report 같은 Decision Material을 준비하는 Round-trip이 Decision Delay와 Human Cost를 만들 수 있다고 했다.
AI가 일을 수행한 뒤에도 사람이 Agent Log를 다시 뒤져 “무엇을 했는지”를 복원하고 Review Material을 새로 만들어야 한다면, AX가 또 다른 Review 자료 준비 업무를 만들어내는 셈이다.
그래서 질문을 바꿨다.
“AI가 일을 다 한 뒤 사람이 Log를 뒤져 근거를 만들 것인가?”
에서
“Execution과 Validation이 일어나는 순간부터 검증에 필요한 근거도 함께 남길 수 있는가?”
로.
3편에서 Decision Context를 나중에 다시 복원하지 말고 판단이 만들어지는 Workflow 안에서 남기고 싶었던 것과 같은 방향이었다.
실제 Source와 Result로 다시 확인할 근거가 필요했다
어떤 Input과 Version을 사용했고, 어떤 Tool과 Condition으로 실행했으며, 실제 Output과 Check 결과가 무엇인지 공식 Source에서 다시 확인할 수 있는 근거(이후 Engineering Evidence로 표현)가 필요했다.
중요한 점은 AI가 Evidence라는 사실을 새로 만들어낸다는 뜻이 아니라는 것이다.
원 Evidence는 Approved Spec, Repository, EDA Tool Result, Simulation Result, Log, Measurement, Golden Reference처럼 조직이 공식 판단 기준으로 인정할 수 있는 Source에서 나온다.
AX의 역할은 그 Engineering Evidence를 수집하고, 검증하고, 구조화해 사람이 Review할 수 있는 상태로 준비하는 것이다.
내가 중요하게 본 Evidence의 성격은 다음과 같다.
Source와 Version/Identity 실행 Condition Actual Result 수행한 Check Exception과 Remaining Risk 결과가 어떤 Source와 Version, 실행 조건에서 만들어졌는지를 다시 추적할 수 있는 정보(이후 Provenance로 표현)
하지만 Evidence가 많다고 Review가 쉬워지는 것도 아니었다.
모든 Command, Log, Diff, Tool Output, Intermediate Result를 그대로 던지면 추적할 수 있는 정보는 늘어도 사람이 해석해야 할 양은 줄지 않는다.
“Evidence는 여기 다 있습니다”라고 수천 줄의 Log를 넘기는 것은 1~2편의 문제를 다시 만드는 일이다.
그래서 특정 Decision에 필요한 Evidence를 사람이 빠르게 Review할 수 있게 구조화할 필요가 있었다.
Decision에 필요한 Evidence를 빠르게 Review할 수 있도록 구조화해야 했다
특정 Decision에 필요한 Engineering Evidence를 Review 목적에 맞게 묶은 Package(이후 Evidence Bundle로 표현)가 필요했다.
Evidence Bundle은 AI의 설명문 그 자체가 아니다.
중요한 것은 검증 가능한 Engineering Evidence가 기반이어야 한다는 점이었다.
어느 Source와 실행에서 나온 결과인지 추적할 수 있는가.
어떤 Check가 실제로 수행됐는가.
Decision에 필요한 핵심 Result가 무엇인지 빠르게 볼 수 있는가.
Exception, Skip, 별도 확인이 필요한 사항, Remaining Risk를 숨기지 않고 보여주는가.
필요하면 Raw Evidence와 공식 Source까지 내려가 다시 확인할 수 있는가.
Summary가 Raw Evidence를 대체해서는 안 된다.
Summary → Structured Evidence → Raw Source
로 내려갈 수 있어야 한다.
내가 중요하게 생각한 방향은 AI를 믿어 달라고 요구하는 것보다, 사람이 Source와 Result를 따라 직접 다시 확인할 수 있는 검증 가능성을 제공하는 것이었다.
Evidence Bundle은 “AI가 맞았으니 믿어 달라”는 자료가 아니다.
AI를 믿지 않아도 사람이 근거를 따라가 독립적으로 검증할 수 있게 하는 구조다.
그래서 핵심 Traceability는
Intent → Execution → Result → Evidence
로 보게 됐다.
아무리 완벽한 Simulation Log가 있어도 원래 확인하려던 Intent와 무관한 Run이면 의미가 없다.
무엇을 확인하려 했고, 무엇을 실제 수행했고, 무엇이 나왔고, 그 Result와 Success 판단을 무엇으로 검증할 수 있는지가 연결되어야 한다.
여러 Source 가운데 어떤 것을 공식 판단 기준으로 볼지도 구분해야 했다
어느 Source를 현재 판단의 기준으로 볼지에 대한 구분(이후 Source Authority로 표현)이 필요했다.
Approved Spec과 과거 Spec Copy는 다르다.
현재 Repository와 개인 Working Directory는 다를 수 있다.
Golden Reference와 Agent-generated Intermediate File의 Authority도 같다 볼 수 없다.
Evidence의 존재뿐 아니라 “이 Source를 이 판단의 기준으로 사용해도 되는가”까지 확인해야 했다.
Golden Reference에 대해서도 경계를 분명히 하고 싶다.
실제 Production Project에서 승인된 Golden Reference가 있다면 적극 활용하는 것이 맞다.
어느 Source를 공식 판단 기준으로 볼지(Source Authority)와 그 결과의 출처·Version·실행 조건(Provenance)을 명확히 하고 현재 Source와 실행 결과와 함께 검토하면 된다.
내가 PoC에서 사용한 No-Golden-Read는 AI가 이미 성공한 Golden Result를 먼저 보고 그 답에 맞추는 식의 누설을 막고, 허용된 Source만으로 독립적으로 생성·검증할 수 있는지 확인하기 위한 Validation Method였다.
Production에서 Golden을 보지 말자는 원칙이 아니다.
Evidence가 준비되면 다음 질문은 “그래서 무엇을 해야 하는가?”가 된다.
다음에 권장하는 조치, 영향을 받는 영역, 다시 수행해야 할 Run과 Validation, 남아 있는 Risk, 사람의 판단이 필요한지까지 함께 정리한 Package를 Action Package로 표현한다.
하지만 여기에서도 Capability와 Permission을 분리해야 한다.
AI가 어떤 일을 할 수 있다는 것과 그 일을 해도 된다는 것은 다르다.
충분히 Qualified된 낮은 Risk 업무는 자동으로 수행하게 할 수 있다.
Evidence와 Condition이 충족되면 조건부로 진행하게 할 수도 있다.
반면 중요한 Design Decision, Exception, Risk Acceptance, Sign-off는 Human Review와 Approval을 요구할 수 있다.
무엇을 어디까지 위임할지, 언제 멈추고 사람에게 판단을 넘길지, 누가 Accountability를 가질지는 Human Decision이다.
결국 AX의 목적은 Human을 Workflow에서 제거하는 것이 아니었다.
자료를 찾고, 모으고, 비교하고, 정리하고, 설명하고, 다시 확인하는 데 쓰던 시간을 줄이고, 사람이 Review, Engineering Judgment, Approval, Risk Acceptance에 더 집중할 수 있게 만드는 것이다.
1편의 Late Decision 문제로 다시 돌아오면 해법은 근거를 줄이는 것이 아니다.
Decision/Review Criteria를 가능한 범위에서 실제로 확인해야 할 항목, 즉 Evidence Requirement로 명확히 만들고, Execution 과정에서 Engineering Evidence를 준비하고, Evidence Bundle을 통해 Human이 Decision-ready 상태에 더 빨리 도달하게 하는 것이다.
다음 편 — 결국 내가 AI가 아니라 사람과 조직에 남기고 싶었던 것은 무엇이었을까?